Yapay Zekâda Yeni Bir Mimari Arayış: TypeSafe AI ve Karar Veren Modellerin Yükselişi
Büyük dil modelleri konuşmayı öğrendi. Peki yazılımların güvenilir biçimde karar vermesini sağlayabildiler mi? TypeSafe AI, System One mimarisiyle yapay zekânın üretim sistemlerindeki rolünü yeniden tanımlamaya çalışıyor.
Yapay zekâ konuşmayı öğrendi. Peki karar vermeyi?
Son birkaç yılda yapay zekâ sektörünün odağında büyük dil modelleri (Large Language Models, LLM) vardı.
Modeller giderek daha uzun metinler yazdı, karmaşık problemleri çözmeye başladı, yazılım geliştirdi ve farklı araçlarla etkileşime girerek çok aşamalı görevleri yerine getirebilir hâle geldi.
Ancak teknolojinin üretim ortamlarında yaygınlaşması, önemli bir mimari sorunu daha görünür kıldı:
Bir modelin doğru cevap üretmesi ile bir yazılım sisteminin güvenle kullanabileceği karar üretmesi aynı şey değil.
Bir müşteri talebinin hangi departmana yönlendirileceğini belirlemek, finansal işlemin risk düzeyini hesaplamak veya güvenlik alarmının gerçek bir tehdit olup olmadığını değerlendirmek için her zaman uzun bir açıklamaya ihtiyaç duyulmuyor.
Çoğu zaman gerekli olan şey daha basit:
- Önceden tanımlanmış seçeneklerden birinin belirlenmesi.
- Kararın olasılığının hesaplanması.
- Belirsizliğin açıkça ifade edilmesi.
- Sonucun yazılım tarafından doğrudan kullanılabilmesi.
Geleneksel büyük dil modelleri bu görevleri yerine getirebiliyor. Fakat temel tasarımları metin üretimine dayanıyor.
Bu nedenle kurumsal uygulamalar, bir dil modelinden gelen cevabı çoğu zaman yapılandırılmış veriye dönüştürmek, doğrulamak ve iş kurallarıyla yeniden değerlendirmek zorunda kalıyor.
15 Eylül 2026'da ilk modelini tanıtan TypeSafe AI, tam olarak bu mimari uyuşmazlığı hedef alıyor.
Şirketin kurucusu Diogo Almeida, OpenAI'deki önceki çalışmalarına da değindiği tanıtım yazısında, sohbet modellerinin başarısına rağmen yazılım otomasyonunun neden aynı hızda ilerlemediğini sorguluyor.
TypeSafe'in önerdiği çözüm ise daha büyük bir sohbet modeli geliştirmek değil.
Metin üretmek yerine doğrudan yapılandırılmış kararlar veren farklı bir model sınıfı oluşturmak.
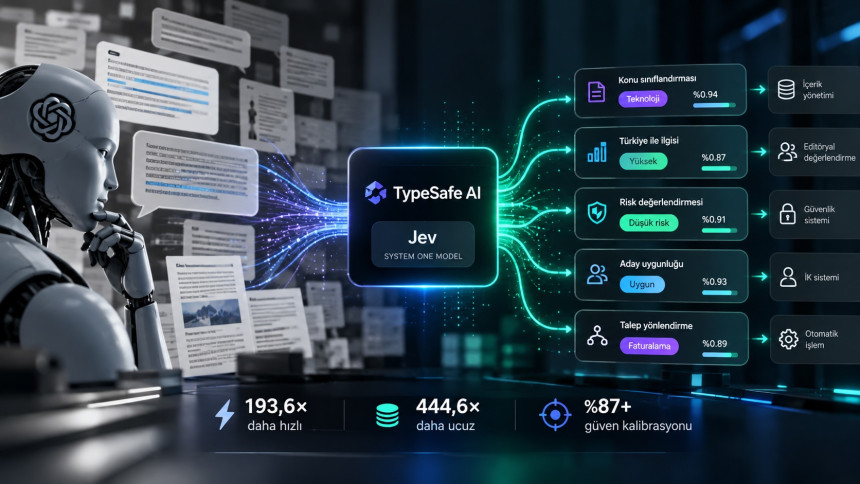
Bu yaklaşımın adı System One Models. İlk kamuya açık modeli ise Jev.
Sorun: Dil üretimi ile yazılım kararları arasındaki uyumsuzluk
Modern büyük dil modellerinin önemli bir bölümü otoregresif üretim mantığıyla çalışıyor.
Basitleştirilmiş biçimiyle model, üreteceği bir sonraki token'ın olasılığını önceki token'lara göre hesaplıyor.
Bu mekanizma doğal dil üretiminde son derece esnek.
Ancak bir yazılımın ihtiyaç duyduğu çıktı çoğu zaman bir metin dizisi değil; belirli bir veri tipine sahip, sınırları tanımlanmış bir değer.
Örneğin kurumsal bir güvenlik sistemi, gelen işlemi üç kategoriden birine yerleştirmek istiyor olsun.
Sistemin ihtiyaç duyduğu sonuç şu bilgilerden oluşabilir:
Risk seviyesi: Yüksek
İnsan incelemesi gerekiyor mu? Evet
Modelin güven skoru: 0,96
Bir dil modeli bu bilgileri JSON biçiminde üretebilir.
Fakat burada birbirinden farklı üç problem bulunuyor.
Birinci problem, biçimsel doğruluk.
Üretilen yanıtın beklenen veri şemasına uygun olması gerekiyor. Bu sorun JSON Schema, constrained decoding ve structured outputs gibi yöntemlerle önemli ölçüde azaltılabiliyor.
İkinci problem, anlamsal doğruluk.
Şemaya tamamen uygun bir çıktı, yine de yanlış bir risk değerlendirmesi içerebilir.
Üçüncü problem, olasılıkların güvenilirliği.
Modelin ürettiği 0,96 değerinin gerçek dünyada ne anlama geldiği belirsiz olabilir.
Model benzer 100 kararın 96'sında gerçekten doğru sonuca ulaşıyor mu?
Yoksa yalnızca kendinden emin bir yanıt mı üretiyor?
İşte üçüncü soru, TypeSafe'in yaklaşımını anlamak açısından kritik.
Yapay zekâ sistemlerinde sorun artık yalnızca doğru cevabı bulmak değil, hangi durumlarda doğru cevabı bulamadığını güvenilir biçimde ölçebilmek.
Bu ayrım, akademik araştırmalarda probability calibration, yani olasılık kalibrasyonu olarak ele alınıyor.
Bir modelin yüksek doğruluk oranına sahip olması, güven skorlarının da doğru kalibre edildiği anlamına gelmiyor.
TypeSafe AI, yazılım sistemlerinin doğrudan kullanabileceği yapılandırılmış ve olasılık temelli kararlar üretmeye odaklanan bir yapay zekâ şirketi.
Şirketin ilk modeli Jev, geleneksel sohbet modellerinden farklı bir kullanım modeli sunuyor.
Temel yaklaşım şöyle özetlenebilir:
Girdi: Sistem durumu ve önceden tanımlanmış sorular.
Çıktı: Veri tipi belirli kararlar, olasılık dağılımları ve ilgili güven ölçümleri.
TypeSafe'in API yaklaşımı, bir sistem durumunun birden fazla soru üzerinden değerlendirilmesine dayanıyor.
Örneğin bir araştırma platformuna yeni bir rapor geldiğini düşünelim.
Sistemin şu sorulara yanıt vermesi gerekiyor:
Karar 1: Raporun temel konusu nedir?
Karar 2: Türkiye ile ilgisi ne düzeyde?
Karar 3: Araştırmacılar açısından önemi nedir?
Karar 4: Editöryal incelemeye gönderilmeli mi?
Geleneksel bir LLM yaklaşımında bütün değerlendirmeler tek bir prompt üzerinden yürütülebilir.
System One yaklaşımında ise her değerlendirme ayrı bir karar birimi olarak tanımlanabiliyor.
Jev'in üç temel karar mekanizmasıChoice: Seçenekler arasından karar verme
Önceden tanımlanmış kategorilerden birinin seçilmesini sağlar.
Örneğin bir araştırma raporunun ekonomi, teknoloji, toplum veya siyaset kategorilerinden hangisine ait olduğunun belirlenmesi.
Score: Belirli bir ölçeğe göre puanlama
Bir içeriğin veya durumun tanımlanmış ölçütler üzerinden değerlendirilmesini sağlar.
Örneğin bir raporun araştırmacılar açısından öneminin 1 ile 5 arasında puanlanması.
Noul: İfade veya durum değerlendirmesi
Bir ifadenin doğruluğunun ya da desteklenme derecesinin değerlendirilmesine yönelik karar türüdür.
Bu mekanizmalar, çok sayıda değerlendirme sorusunun tek bir model çağrısında işlenmesini mümkün kılıyor.
TypeSafe'in teknik dokümantasyonu, soruların ortak sistem durumu üzerinde birlikte değerlendirilebildiğini açıklıyor.
Bu ayrımın önemli bir yazılım mühendisliği sonucu bulunuyor:
Kararların nasıl birleştirileceği modelin serbest yorumuna bırakılmak zorunda değil.
Örneğin bir araştırma platformu, içerik seçiminde aşağıdaki ağırlıkları kullanabilir:
- Araştırma değeri: %50
- Türkiye ile ilgisi: %30
- Teknik derinlik: %20
Nihai yayın önceliği bu ölçütlerden hesaplanabilir.
Böyle bir mimaride model, her değerlendirme için gerekli tahmini üretir. Son kararın hangi kurallara göre verileceğini ise uygulama belirler.
Bu da karar mantığının daha kolay test edilmesini, sürümlenmesini ve denetlenmesini sağlayabilir.
Ancak burada önemli bir sınır bulunuyor:
Yapılandırılmış sonuç üretmek, kararın doğru veya tarafsız olduğunu garanti etmiyor.
Bir model beklenen veri tipini hiç bozmadan sistematik olarak yanlış kararlar da verebilir.
Dolayısıyla TypeSafe'in yaklaşımını değerlendirirken şema güvenilirliği ile karar güvenilirliğini birbirinden ayırmak gerekiyor.
TypeSafe'in yaklaşımındaki temel teknik yenilik iddiası, Reinforcement Learning for Calibrated Decisions (RLCD) adı verilen eğitim yöntemi.
Türkçeye Kalibre Edilmiş Kararlar için Pekiştirmeli Öğrenme olarak çevrilebilir.
Şirket, bu yöntemi yeni model mimarisi ve paralel örnekleme altyapısıyla birlikte geliştirdiğini belirtiyor.
Burada geleneksel dil modeli eğitiminden farklı bir optimizasyon hedefi söz konusu.
Yapay zekâ eğitim yaklaşımları1. RLHF (Reinforcement Learning from Human Feedback)
Temel optimizasyon hedefi, insanların tercih ettiği yanıtları üretmektir.
Özellikle sohbet sistemleri ve talimat takibi gibi uygulamalarda kullanılır.
2. RLVR (Reinforcement Learning with Verifiable Rewards)
Programatik olarak doğrulanabilen sonuçların üretilmesine odaklanır.
Matematik, kod üretimi ve doğrulanabilir problemlerin çözümü başlıca kullanım alanlarıdır.
3. RLCD (Reinforcement Learning for Calibrated Decisions)
Belirsizliği doğru yansıtan, olasılıkları kalibre edilmiş kararlar üretmeyi hedefler.
Sınıflandırma, puanlama ve kurumsal otomasyon gibi uygulamalara odaklanır.
Bu yaklaşımlar birbirlerini tamamen dışlayan eğitim yöntemleri değildir. Farklı optimizasyon hedeflerini ön plana çıkarırlar.
Kalibrasyon neden önemli?Bir finansal işlemin şüpheli olup olmadığını değerlendiren sistemi ele alalım.
Model işlemin dolandırıcılık olasılığını %87 olarak hesaplıyor olsun.
Bu sonuç, tek başına işlemin dolandırıcılık olduğunu kanıtlamaz.
Ancak model doğru kalibre edilmişse, benzer koşullarda %87 olasılık atanan çok sayıda işlemden yaklaşık %87'sinin gerçekten dolandırıcılık olması beklenir.
Bu özellik, olasılık tahmininin güvenilirliği açısından büyük önem taşıyor.
Kalibrasyon nasıl ölçülüyor?
Makine öğrenmesinde yaygın kullanılan ölçütlerden biri Expected Calibration Error (ECE).
ECE, modelin ifade ettiği güven düzeyi ile gerçekleşen doğruluk oranı arasındaki farkı ölçer.
Örneğin:
Bir model 1.000 tahmin için ortalama %90 güven bildirmiş olsun.
Ancak bu tahminlerin yalnızca 750'si doğru çıkmışsa gerçekleşen doğruluk %75'tir.
Bu durumda modelin güven düzeyi ile gerçek doğruluk arasında 15 yüzde puanlık fark bulunur.
Model, tahminlerinin güvenilirliğini olduğundan yüksek göstermektedir.
Bir başka yaygın ölçüt ise Brier Score'dur.
Brier Score, tahmin edilen olasılık ile gerçekleşen sonuç arasındaki karesel farkı ölçer.
İkili sınıflandırmada daha düşük Brier Score, daha iyi olasılık tahminine işaret eder.
Ancak bu ölçütlerin hiçbiri tek başına bütün güvenilirlik sorunlarını açıklamaz.
2026 araştırmaları ne söylüyor?
Mayıs 2026'da yayımlanan Assessing and Mitigating Miscalibration in LLM-Based Social Science Measurement başlıklı araştırma, bu sorunu doğrudan sosyal bilimler açısından ele alıyor.
Jinyuan Wang, Ningyuan Deng ve Yi Yang tarafından hazırlanan çalışma, büyük dil modellerinin yapılandırılmamış metinlerden araştırma değişkenleri üretirken karşılaştığı kalibrasyon sorunlarını inceliyor.
Araştırmada 14 farklı sosyal bilim yapısı üzerinden çeşitli model aileleri değerlendiriliyor.
Araştırmacılar, modellerin bildirdiği güven düzeyleri ile gerçekleşen doğruluk arasında önemli uyumsuzluklar tespit ediyor.
Daha dikkat çekici olan ise önerdikleri çözüm.
Araştırmacılar, dil modellerinden elde edilen tahminleri ve güven bilgilerini daha küçük bir sınıflandırıcıya aktaran bir yöntem kullanıyor.
Bu yaklaşım, veri kümeleri genelinde ortalama olarak:
Expected Calibration Error değerinde %43,2 azalma sağlıyor.
Brier Score değerinde %34,0 azalma sağlıyor.
Bu sonuçlar TypeSafe modelinin performansını göstermiyor.
Ancak TypeSafe'in çözmeye çalıştığı problemin bilimsel açıdan neden önemli olduğunu ortaya koyuyor.
Araştırmanın temel mesajı açık:
Yapay zekânın araştırmalarda ürettiği güven skorları, ölçüm kalitesinin doğrudan bir parçasıdır.
Üstelik bu çalışma önemli bir alternatif yaklaşımı da gösteriyor.
Kalibre edilmiş kararlar üretmek için mutlaka tamamen yeni bir model mimarisi gerekmeyebilir.
Daha küçük sınıflandırıcılar, model damıtma yöntemleri ve sonradan uygulanan kalibrasyon teknikleri de etkili olabilir.
Dolayısıyla TypeSafe'in RLCD yaklaşımının gerçekten üstün olup olmadığını belirlemek için geleneksel sınıflandırma modelleriyle de karşılaştırılması gerekiyor.
TypeSafe'in tanıtımında en çok dikkat çeken iki rakam bulunuyor:
193,6 kat daha hızlı.
444,6 kat daha ucuz.
Bunlar son derece güçlü iddialar.
Ancak hangi görevlerin, hangi modellerle ve hangi koşullarda karşılaştırıldığını incelemeden bu rakamların bütün yapay zekâ uygulamaları için geçerli olduğu sonucuna varmak yanlış olur.
TypeSafe, resmi açıklamasında bu değerlerin kendi System One iş akışı değerlendirmelerinden geldiğini belirtiyor.
Şirket ayrıca bu kazanımların gerçek dünyada beklenebilecek iyileşmelerin üst sınırına yakın olabileceğini açıkça kabul ediyor.
TypeSafe'in yayımladığı performans verileriHız avantajı: 193,6 kat
Şirketin seçili System One iş akışı değerlendirmesinden elde edilen sonuç.
Maliyet avantajı: 444,6 kat
Aynı değerlendirme kapsamındaki maliyet karşılaştırması.
Yanıt süresi: 70–500 milisaniye
Şirketin açıkladığı tipik uçtan uca yanıt süresi aralığı.
Girdi fiyatı: 1 milyon token başına 0,042 dolar
Şirketin duyurduğu API fiyatlandırması.
1 milyar girdi token maliyeti: 42 dolar
Aynı fiyatlandırmanın daha büyük kullanım hacmine uyarlanmış karşılığı.
Çıktı token maliyeti: Ayrı ücretlendirme bulunmuyor
Şirket, yapılandırılmış çıktıların ayrıca ücretlendirilmediğini belirtiyor.
Bu veriler bağımsız laboratuvar sonuçları değil, TypeSafe'in kendi yayımladığı değerlerdir.
Performans artışı nereden geliyor?Geleneksel bir otoregresif modelde üretim büyük ölçüde sıralı ilerliyor.
Model önce ilk token'ı, ardından ikinci token'ı ve sonraki token'ları üretiyor.
Bu nedenle toplam yanıt süresi, üretilen token sayısından etkileniyor.
TypeSafe ise kendi açıklamasına göre birden fazla karar değişkenini paralel değerlendiriyor.
Böylece uzun yanıt dizileri üretmek yerine, sınırları önceden belirlenmiş karar alanlarına ilişkin çıktılar elde ediliyor.
Bu yaklaşım, özellikle çok sayıda kısa ve bağımsız kararın gerektiği uygulamalarda avantaj sağlayabilir.
Ancak söz konusu avantajın yalnızca paralel işlemden kaynaklandığı söylenemez.
Model boyutu, donanım, sunucu kapasitesi, ağ gecikmesi, çıktı uzunluğu ve karşılaştırılan modellerin muhakeme ayarları da toplam süreyi etkiler.
Benchmark sonuçlarının önemli sınırlamalarıTypeSafe, dört farklı otomasyon iş akışı için değerlendirme yayımlıyor.
Bunlar güvenlik olayları, yapay zekâ ajanlarının işlem izleri, fatura işleme ve müşteri hizmetleri kararları üzerine kurulu.
Şirketin testlerinde, aynı iş politikasını tek ve uzun bir prompt olarak uygulamak yerine küçük kararlara bölmek, incelenen modellerin genelinde daha iyi sonuçlar verebiliyor.
Bu, yalnızca Jev'e özgü bir bulgu değil.
Yapay zekâ uygulamalarının mimarisine ilişkin daha genel bir mühendislik sonucuna işaret ediyor.
Bununla birlikte deney tasarımında birkaç sınırlama bulunuyor.
İlk olarak, karşılaştırmada kullanılan referans cevaplar bağımsız insan uzmanların kesinleştirdiği doğrular yerine, güçlü dil modellerinin tahminlerinden oluşturuluyor.
İkinci olarak, örnek iş akışları TypeSafe'in kendi model yetenekleri ekibi tarafından hazırlanmış.
Üçüncü olarak, karşılaştırılan modellerin muhakeme düzeyleri ve yapılandırılmış çıktı üretme maliyetleri sonuçları etkileyebiliyor.
Şirket bu sınırlamaların önemli bölümünü kendi teknik yazısında da açıklıyor.
Dolayısıyla yayımlanan sonuçlardan şu çıkarım yapılabilir:
TypeSafe, seçili yapılandırılmış karar iş akışlarında dikkat çekici bir hız ve maliyet avantajı bildirmiş durumda.
Ancak bu veriler, Jev'in bütün sınıflandırma modellerinden veya bütün LLM tabanlı sistemlerden daha başarılı olduğunu kanıtlamıyor.
TypeSafe'in 7 Ekim 2026'da yayımladığı bir müşteri örneği, teknolojinin yalnızca teorik bir mimari önerisi olmadığını gösteriyor.
Yapay zekâ destekli işe alım platformu Jack & Jill, aday eşleştirme süreçlerinin bir aşamasında kullandığı Gemini 3.1 Flash Lite modelini Jev ile değiştirdiğini açıkladı.
Şirketin aktardığı bilgilere göre sistem, her açık pozisyon için binlerce adayı değerlendiriyor.
Bu süreçte ilk aşamanın görevi, aday havuzunu daha küçük bir listeye indirmek.
Dolayısıyla modelden uzun bir değerlendirme raporu yazması değil, adayların uygunluğunu puanlaması bekleniyor.
Açıklanan sonuçlarMaliyet: %88 daha düşük
Gemini kullanıldığında 1.000 adayın değerlendirilmesi yaklaşık 0,755 dolara mal olurken Jev ile bu maliyet 0,092 dolara düşüyor.
İşlem süresi: Yaklaşık %50 azalma
Bir pozisyon için aday değerlendirmesinin ortanca süresi 20,3 saniyeden 10,3 saniyeye geriliyor.
Aday yakalama oranı: %93,9'dan %94,6'ya
İşe alım yöneticilerinin daha sonra görüşmek istediği adayların ilk eleme aşamasında korunma oranı, Jev ile 0,7 yüzde puan yükseliyor.
Ancak şirketin yayımladığı değerlendirmeye göre bu fark istatistiksel olarak anlamlı değil.
Sıralama kalitesi: AUC 0,924'ten 0,933'e
AUC, modelin uygun adayları diğer adayların önünde sıralama başarısını değerlendiren ölçütlerden biri.
Tahmini yıllık tasarruf: 500.000 doların üzerinde
Bu değer gerçekleşmiş yıllık tasarruf değil, şirketin gelecek 12 aylık kullanım hacmine dayanan projeksiyonu.
Değerlendirme 150 gerçek açık pozisyon üzerinde gerçekleştirilmiş.
Bu sonuçların doğrudan müşteri tarafından bağımsız olarak yayımlanmış bir akademik çalışma olmadığını da belirtmek gerekiyor. Veriler, TypeSafe'in yayımladığı müşteri başarı hikâyesinden geliyor.
Buna rağmen kullanım örneği önemli bir noktayı gösteriyor:
Yapay zekâ maliyetlerinin düşürülmesi yalnızca daha ucuz token üretmekle ilgili değil. Görev için doğru model mimarisini seçmek de belirleyici olabilir.
TypeSafe'in kullandığı en iddialı ifadelerden biri, Jev'in halüsinasyon üretmediği yönünde.
Bu iddianın teknik anlamını doğru yorumlamak gerekiyor.
Geleneksel bir dil modeli, var olmayan bir kaynak, hatalı bir komut veya gerçekte bulunmayan bir yazılım parametresi üretebilir.
Çıktı alanı önceden belirlenmiş seçeneklerle sınırlandığında bu tür serbest biçimli üretim hatalarının önemli bir bölümü ortadan kaldırılabilir.
Örneğin bir modelin yalnızca şu kategorilerden seçim yapabildiğini düşünelim:
- Critical
- High
- Medium
- Low
Modelin beşinci ve geçersiz bir kategori üretmesi, sistem tarafından yapısal olarak engellenebilir.
Ancak modelin gerçekte kritik olan bir olayı düşük riskli olarak sınıflandırması hâlâ mümkündür.
Bu hata, veri tipi açısından geçerli ancak anlam açısından yanlış bir karardır.
İki farklı güvenilirlik türü1. Yapısal güvenilirlik
Modelin yalnızca izin verilen veri tiplerini ve seçenekleri üretmesi.
TypeSafe'in mimarisi bu alanda güçlü bir garanti sunmayı hedefliyor.
2. Anlamsal güvenilirlik
Üretilen kararın gerçek durumla örtüşmesi.
Bu özellik modelin eğitimine, veri kalitesine, karşılaştığı senaryolara ve karar eşiklerine bağlı.
Bir sistemin yapısal olarak hatasız olması, anlamsal olarak hatasız olduğu anlamına gelmiyor.
Dolayısıyla TypeSafe'in sıfır halüsinasyon ifadesi, serbest metin üretiminden kaynaklanan hataların ortadan kaldırılması bağlamında değerlendirilmelidir.
Yanlış sınıflandırma, hatalı puanlama ve eksik bağlam nedeniyle verilen kararlar hâlâ mümkündür.
TypeSafe'in yaklaşımı, kurumsal yapay zekâ uygulamaları açısından daha geniş bir soruyu gündeme getiriyor.
Her problem için genel amaçlı büyük bir dil modeli kullanmak gerekli mi?
Bir müşteri destek sistemini düşünelim.
Gelen mesajın anlamını çözmek, müşterinin talebini sınıflandırmak ve ilgili departmana yönlendirmek için büyük bir dil modeli kullanılabilir.
Ancak her müşteri mesajının yüzlerce tokenlık değerlendirmelerden geçirilmesi ekonomik açıdan verimli olmayabilir.
Özellikle milyonlarca işlemin gerçekleştirildiği sistemlerde küçük maliyet farkları büyüyebilir.
İki katmanlı yapay zekâ mimarisiGelecekte daha sık karşılaşabileceğimiz yaklaşım, farklı yapay zekâ modellerinin görevlerine göre ayrıştırılması.
Birinci katman: Hızlı karar modelleri
Bu katmanda sınıflandırma, yönlendirme, puanlama ve risk değerlendirmesi yapılır.
Önceden tanımlanmış görevler için düşük gecikme ve düşük maliyet hedeflenir.
İkinci katman: Genel amaçlı büyük dil modelleri
Daha karmaşık muhakeme, uzun metin üretimi, araştırma sentezi, yazılım geliştirme ve çok aşamalı problemlerin çözümü bu katmanda gerçekleştirilir.
Böylece her işlem için en büyük ve en pahalı modeli çalıştırmak yerine, görevin gerektirdiği kapasiteye uygun model seçilebilir.
Ancak bu yaklaşımın kendisi tamamen yeni değil.
Makine öğrenmesinde uzun süredir kullanılan model yönlendirme, cascade inference, ensemble learning ve uzman modeller gibi yöntemlerle benzer tasarımlar geliştiriliyor.
TypeSafe'in farklılaşma iddiası, karar üretimini mevcut dil modellerinin üzerine eklenen bir katman olmaktan çıkarıp modelin temel işlevi hâline getirmesi.
Bu nedenle şirketin yaklaşımını değerlendirirken iki soruya yanıt aranmalı.
Birincisi: Jev, aynı doğruluk düzeyinde geleneksel sınıflandırıcılardan daha verimli mi?
İkincisi: Jev, yeni görevleri öğrenme ve farklı alanlara uyum sağlama bakımından daha esnek mi?
Bu soruların yanıtı, teknolojinin uzun vadeli konumunu belirleyecek.
TypeSafe'in yaklaşımının dikkat çekici kullanım alanlarından biri araştırma ve veri analizi süreçleri olabilir.
Araştırma kuruluşları artık yalnızca anket yanıtlarını analiz etmiyor.
Açık uçlu yanıtlar, sosyal medya içerikleri, görüşme dökümleri, müşteri yorumları, akademik yayınlar ve dijital davranış verileri de araştırma süreçlerinin parçası hâline geliyor.
Bu verilerin ortak özelliği, büyük bölümünün yapılandırılmamış olması.
Büyük dil modelleri, bu içeriklerin analiz edilmesinde önemli fırsatlar sunuyor.
Ancak bir araştırmanın güvenilirliği, üretilen sınıflandırmaların doğruluğuna bağlı.
Açık uçlu yanıtların kodlanmasıBir araştırmada 50.000 katılımcının açık uçlu yanıt verdiğini düşünelim.
Araştırmacılar bu yanıtları belirli kategorilere ayırmak istiyor.
Örneğin:
- Fiyat memnuniyetsizliği
- Hizmet kalitesi
- Ürün deneyimi
- Marka algısı
- Diğer konular
Geleneksel yöntemde insan kodlayıcılar kullanılır.
Yapay zekâ destekli yöntemde ise model her yanıtı sınıflandırır.
Ancak modelin her kararı aynı güvenilirlik düzeyinde değildir.
Bazı yanıtlar açık ve kolay sınıflandırılabilir.
Bazıları ise birden fazla kategoriyle ilişkili olabilir.
Bu durumda olasılık temelli bir yaklaşım, araştırmacılara yalnızca bir kategori değil, sınıflandırmanın ne kadar güvenilir olduğunu da gösterebilir.
İnsan denetiminin daha verimli kullanılmasıÖrneğin 50.000 açık uçlu yanıtın değerlendirildiği varsayımsal bir sistemde şu kurallar uygulanabilir:
%95 ve üzeri güven: Otomatik sınıflandırma.
%75–95 arası güven: Örneklem üzerinden kalite kontrol.
%75 altı güven: İnsan kodlayıcı incelemesi.
Bu eşikler örnek amaçlıdır; TypeSafe tarafından önerilmiş veya bilimsel olarak doğrulanmış standartlar değildir.
Gerçek uygulamada eşiklerin bağımsız doğrulama verileriyle belirlenmesi gerekir.
Ayrıca bütün yüksek güvenli yanıtların denetim dışı bırakılması da doğru olmayabilir.
Sistematik hataları tespit etmek için yüksek güven grubundan da rastgele örnekler incelenmelidir.
Bu mimarinin amacı insan değerlendirmesini tamamen ortadan kaldırmak değil, insan emeğini daha fazla belirsizlik içeren durumlara yönlendirmektir.
Sosyal bilim araştırmaları ne gösteriyor?30 Temmuz 2026'da yayımlanan Beyond the Conventional Pipeline: Large Language Models for Social Science Measurement başlıklı akademik çalışma, büyük dil modellerinin sosyal bilimlerdeki ölçüm süreçlerine nasıl entegre edilmesi gerektiğini tartışıyor.
Araştırma, LLM'lerin çoğunlukla mevcut ölçüm sürecindeki insan kodlayıcıların yerine konulduğunu belirtiyor.
Ancak daha önemli soru şu:
Yeni yapay zekâ olanakları karşısında araştırmanın ölçüm mimarisi baştan tasarlanmalı mı?
Bu yaklaşım, TypeSafe'in model mimarisine yönelik önerisiyle kavramsal açıdan örtüşüyor.
Her iki durumda da mesele, mevcut iş akışına yalnızca bir yapay zekâ aracı eklemekten daha geniş.
Mesele, verinin nasıl işlendiğini ve kararların nasıl üretildiğini yeniden tasarlamak.
Yine de modelin verdiği bir sınıflandırmanın araştırma açısından geçerli kabul edilebilmesi için kültürel bağlam, kavramsal geçerlilik, örneklem farklılıkları ve kodlayıcılar arası tutarlılık gibi ölçütlerin değerlendirilmesi gerekiyor.
Düşük maliyetli sınıflandırma, tek başına bilimsel geçerlilik sağlamıyor.
Karar modellerinin kurumlarda kullanılması, yeni güvenlik ve yönetişim sorularını da beraberinde getiriyor.
Örneğin bir siber güvenlik sisteminin alarmları otomatik olarak sınıflandırdığını düşünelim.
Model bir alarmı düşük riskli olarak değerlendiriyor ve sistem alarmı kapatıyor.
Bu durumda yanlış negatif bir kararın maliyeti yüksek olabilir.
Benzer şekilde finansal işlemlerin engellenmesi, kredi değerlendirmesi veya işe alım süreçlerinde verilen kararların etkisi yalnızca teknik değildir.
Bu kararlar insanları ve kurumları doğrudan etkileyebilir.
Kalibre edilmiş olasılıklar yeterli mi?Hayır.
Bir karar modelinin kurumsal kullanımında en az beş kontrol mekanizması gerekir.
1. Karar eşikleri
Modelin hangi güven veya risk düzeyinde otomatik işlem gerçekleştirebileceği önceden belirlenmelidir.
2. İnsan onayı
Yüksek etkili kararlar için insan incelemesi ve gerektiğinde müdahale mekanizması bulunmalıdır.
3. Denetim kayıtları
Modelin hangi girdiye dayanarak hangi çıktıyı ürettiği izlenebilmelidir.
4. Model sürüm kontrolü
Model güncellendiğinde karar dağılımlarının nasıl değiştiği ölçülmelidir.
5. Sürekli performans değerlendirmesi
Modelin gerçek ortamda zaman içinde doğruluk, kalibrasyon ve hata oranları açısından nasıl davrandığı takip edilmelidir.
Buna ek olarak veri gizliliği, erişim kontrolü, veri saklama politikaları ve üçüncü taraf hizmet sağlayıcılarla veri paylaşımı da değerlendirilmelidir.
Özellikle kişisel verilerin işlendiği sistemlerde GDPR, KVKK ve ilgili sektörel düzenlemeler tasarımın başlangıç aşamasından itibaren dikkate alınmalıdır.
Kısacası güvenilir yapay zekâ, yalnızca model mimarisiyle elde edilemez.
Güvenilirlik, modelin özellikleri kadar onu kullanan yazılımın ve kurumun yönetişim yapısına da bağlıdır.
TypeSafe, 9 Ekim 2026'da yeni finansman turunu duyurdu.
Şirketin açıklamasına göre Andreessen Horowitz liderliğinde gerçekleştirilen A Serisi yatırım turunda 870 milyon dolar finansman sağlandı.
Açıklanan şirket değerlemesi ise 7,5 milyar dolar.
Yatırıma Sequoia Capital ve DCVC gibi yatırımcıların da katıldığı belirtiliyor.
Bu büyüklükte bir yatırım, karar odaklı yapay zekâ mimarilerine yönelik ticari beklentinin dikkat çekici bir göstergesi.
Şirket ayrıca Fortune 500 şirketlerinin yaklaşık üçte birinin Jev'i kullandığını veya denediğini ifade ediyor.
Ancak bu açıklama, söz konusu şirketlerin tamamında üretim ölçeğinde kullanım bulunduğu anlamına gelmiyor.
Kullanım kapsamı, işlem hacmi ve elde edilen ekonomik fayda açısından daha ayrıntılı bağımsız verilere ihtiyaç var.
Yatırım büyüklüğü de tek başına teknolojik başarının kanıtı değil.
Asıl belirleyici unsur, mimarinin gerçek üretim sistemlerinde sürdürülebilir doğruluk, düşük maliyet ve operasyonel güvenilirlik sağlayıp sağlayamayacağı olacak.
Jev'in mimari yaklaşımı umut verici olsa da yanıtlanması gereken önemli sorular bulunuyor.
Model farklı alanlara ne kadar iyi uyum sağlıyor?Bir güvenlik olayını sınıflandırmak ile bir araştırma raporunun bilimsel değerini değerlendirmek aynı problem değil.
İlkinde olay özellikleri ve tehdit göstergeleri belirleyici olabilir.
İkincisinde kavramsal bağlam, araştırma tasarımı ve bilimsel yöntem önem kazanır.
Modelin alanlar arasında ne kadar başarılı genelleme yapabildiği daha geniş değerlendirmeler gerektiriyor.
Kalibrasyon zaman içinde korunuyor mu?Bir model belirli bir veri kümesinde doğru kalibre edilmiş olabilir.
Ancak kullanıcı davranışları, pazar koşulları veya tehdit türleri değiştiğinde aynı kalibrasyon düzeyini koruyamayabilir.
Makine öğrenmesinde bu sorun veri dağılımı değişimi ve concept drift kavramlarıyla ilişkilendiriliyor.
Dolayısıyla üretim sistemlerinde kalibrasyonun sürekli ölçülmesi gerekiyor.
Karmaşık muhakeme görevlerinde sınır nerede?Bir kararın verilebilmesi için uzun bir belgeyi anlamak, farklı kaynaklar arasında ilişki kurmak veya çok aşamalı çıkarım yapmak gerekebilir.
Bu tür görevlerde genel amaçlı büyük dil modellerinin esnekliği önemli bir avantaj sağlayabilir.
TypeSafe'in yaklaşımı, özellikle yapısı önceden tanımlanabilen karar problemlerine odaklanıyor.
Bu nedenle Jev'in bütün LLM kullanım alanlarının yerine geçmesi beklenmemeli.
Geleneksel makine öğrenmesiyle karşılaştırma yeterli mi?TypeSafe'in sunduğu karşılaştırmalar ağırlıklı olarak büyük dil modellerine odaklanıyor.
Ancak birçok sınıflandırma problemi zaten yıllardır lojistik regresyon, gradient boosting, BERT tabanlı sınıflandırıcılar ve benzeri yöntemlerle çözülüyor.
Yeni bir karar modelinin ekonomik değerini anlamak için yalnızca genel amaçlı LLM'lerle değil, görev için optimize edilmiş bu alternatiflerle de karşılaştırılması gerekiyor.
Kararların açıklanabilirliği nasıl sağlanacak?Bir modelin %93 güvenle karar vermesi, o kararın neden verildiğini açıklamıyor.
Özellikle düzenlemeye tabi sektörlerde kararın gerekçesi, kullanılan özellikler ve olası önyargılar önem taşıyor.
Yalnızca güven skoru üretmek, açıklanabilirlik sorununu çözmüyor.
Yapay zekâ sektörü son yıllarda büyük ölçüde model kapasitesini artırmaya odaklandı.
Daha fazla parametre, daha uzun bağlam pencereleri, daha güçlü muhakeme ve daha geniş görev kapsamı önemli gelişmeler sağladı.
Ancak kurumsal otomasyonun ihtiyaçları her zaman aynı yönde ilerlemiyor.
Bir yazılım sisteminin milyonlarca işlemi değerlendirmesi gerektiğinde temel öncelikler değişiyor.
Hız, maliyet, tutarlılık, güvenilirlik ve denetlenebilirlik daha fazla önem kazanıyor.
TypeSafe AI'nin System One yaklaşımı, bu ihtiyaçlara farklı bir mimariyle yanıt vermeye çalışıyor.
Şirketin iddiası basit:
Her yapay zekâ problemi bir metin üretim problemi olmak zorunda değil.
Bazen yazılımın ihtiyacı uzun bir açıklama değil, doğru kalibre edilmiş tek bir karar.
Jev'in açıklanan performans sonuçları dikkat çekici. Özellikle aday değerlendirme örneğinde bildirilen %88 maliyet azalması ve yaklaşık iki kat hız artışı, bu tür mimarilerin ekonomik potansiyeline işaret ediyor.
Ancak şirketin kendi benchmark sonuçları ile bağımsız olarak doğrulanmış bilimsel bulgular birbirine karıştırılmamalı.
Henüz yanıtlanmamış sorular var.
Karar modelleri farklı sektörlerde aynı başarıyı gösterebilecek mi?
Model kalibrasyonu gerçek dünyadaki değişimlere dayanabilecek mi?
Geleneksel küçük sınıflandırıcılara karşı sürdürülebilir üstünlük sağlanabilecek mi?
Ve belki de en önemlisi:
Yapay zekâ sistemleri, doğru karar vermek kadar yanlış karar verebileceklerini de güvenilir biçimde ifade etmeyi başarabilecek mi?
TypeSafe'in uzun vadeli başarısını bu soruların yanıtları belirleyecek.
Bugün için daha geniş bir sonuç çıkarmak mümkün.
Yapay zekânın bir sonraki gelişim aşaması yalnızca daha büyük, daha güçlü ve daha fazla konuşabilen modellerden oluşmayabilir.
Daha küçük, daha hızlı, göreve özel ve belirsizliğini ölçebilen sistemler de bu dönüşümün önemli bir parçası olabilir.
Çünkü yapay zekânın üretim sistemlerindeki gerçek değeri, ne kadar etkileyici konuştuğundan çok, ne kadar güvenilir karar verebildiğiyle ölçülecek.
1. TypeSafe AI (15 Eylül 2026)
Introducing System One Models & Jev
System One mimarisi, RLCD yaklaşımı, Jev'in teknik özellikleri, performans iddiaları ve değerlendirme sınırlamaları.
https://typesafe.ai/blog/introducing-system-one-models-and-jev
2. TypeSafe AI (7 Ekim 2026)
Jack & Jill & Jev: Cutting Candidate Screening Costs by 88%
Jev'in aday eşleştirme sisteminde kullanımına ilişkin müşteri örneği. Maliyet, hız ve sıralama kalitesi verileri.
https://typesafe.ai/blog/jack-jill-jev-case-study
3. TypeSafe AI (9 Ekim 2026)
TypeSafe A Raises Series AI
870 milyon dolarlık A Serisi finansman turu, 7,5 milyar dolarlık değerleme ve şirketin büyüme açıklamaları.
https://typesafe.ai/blog/series-ai
4. Wang, J., Deng, N. ve Yang, Y. (2026)
Assessing and Mitigating Miscalibration in LLM-Based Social Science Measurement
Büyük dil modellerinde sosyal bilim ölçümleri, güven kalibrasyonu ve BERT tabanlı kalibrasyon yöntemleri.
https://arxiv.org/abs/2605.11954
5. Bao, L. (2026)
Beyond the Conventional Pipeline: Large Language Models for Social Science Measurement
Chinese Political Science Review.
Büyük dil modellerinin sosyal bilim araştırmalarında ölçüm süreçlerine entegrasyonu ve alternatif araştırma mimarileri.
https://doi.org/10.1007/s41111-026-00351-4
6. TypeSafe AI API Documentation (2026)
Jev'in API yapısı, sistem durumu üzerinden soru değerlendirme mekanizması ve yapılandırılmış karar çıktıları.
7. TypeSafe AI
Lies, Damned Lies, and Benchmarks
Yapay zekâ benchmark değerlendirmelerinde ölçüm yanlılığı, test tasarımı ve bağımsız değerlendirme ihtiyacı.
https://typesafe.ai/blog/antibenchmaxxing
Editör notu: Bu yazı, 10 Ekim 2026 itibarıyla kamuya açık şirket açıklamaları, teknik dokümantasyon, kullanım örnekleri ve akademik araştırmalar temel alınarak hazırlanmıştır. TypeSafe'in performans ve ticari kullanım verileri şirket tarafından bildirilen sonuçlardır. Bağımsız akademik bulgular, bu iddiaların doğrudan doğrulaması olarak değerlendirilmemelidir.


“Kaotik Retorik”
“Bir köksap ne başlar ne de biter. O hep ortadadır, şeylerin arasında, bir ara-varlık, int...